მთავარი
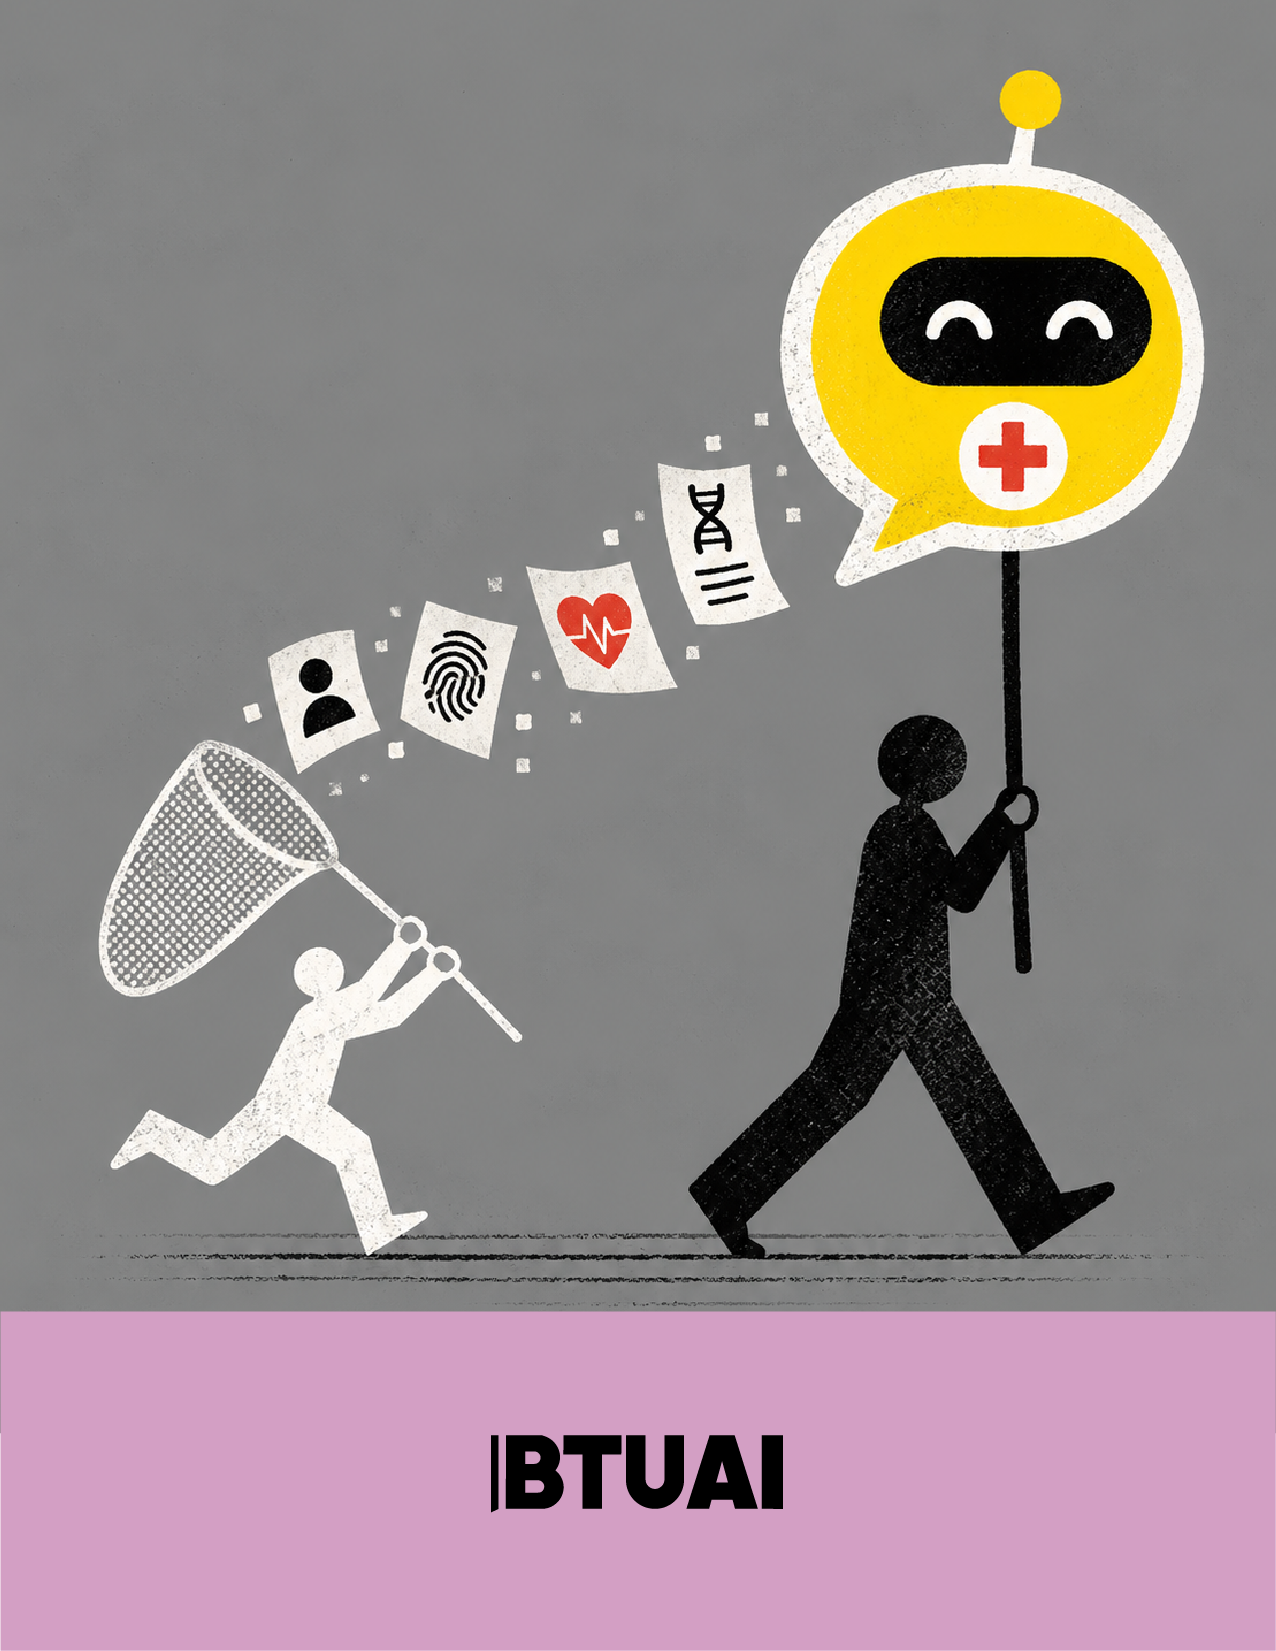
ადამიანები AI ასისტენტებს უკვე აწვდიან ძილის, გულისცემის, ვარჯიშის, კვების, განწყობისა და სამუშაო სტრესის მონაცემებს, რათა მიიღონ პერსონალური რჩევები. საქართველოში ეს ტენდენცია სწრაფად შეიძლება გავრცელდეს: 2025 წელს ბოლო სამი თვის განმავლობაში ინტერნეტის მომხმარებელთა 52.1% ონლაინ ჯანმრთელობასთან დაკავშირებულ ინფორმაციას ეძებდა. მაგრამ AI-ისთვის ბევრი მონაცემის მიწოდება ავტომატურად უკეთეს ჯანმრთელობის გადაწყვეტილებას არ ნიშნავს. მთავარი საკითხია, შეუძლია თუ არა მომხმარებელს გაარჩიოს კეთილდღეობის ინსტრუმენტი სამედიცინო სისტემისგან, მართოს მონაცემთა შემდგომი გამოყენება და შეამჩნიოს მომენტი, როდესაც პერსონალიზებული რჩევა ცრუ თავდაჯერებად იქცევა.
პერსონალიზაცია იწყება მონაცემთა გაერთიანებით
The Wall Street Journal-ის მასალა აღწერს მომხმარებლებს, რომლებიც სხვადასხვა მოწყობილობისა და აპლიკაციის მონაცემებს AI ჩატბოტებში აერთიანებენ. ისინი ერთმანეთს უკავშირებენ გულისცემის ცვალებადობას, ძილის ხარისხს, კალენდარს, კვებას, სამუშაო შეხვედრებსა და განწყობას. მიზანი მარტივია: ცალკეული გრაფიკების ნაცვლად მიიღონ ერთიანი ახსნა და ყოველდღიური ქმედების გეგმა.
ამ მოდელს რეალური სარგებელი აქვს. საათი შეიძლება აჩვენებდეს ცუდ ძილს, კალენდარი – გადატვირთულ დღეს, ხოლო ვარჯიშის აპი – შესრულების შემცირებას. ცალ-ცალკე ეს მონაცემები მხოლოდ სიგნალებია. ერთად დამუშავებამ შესაძლოა ადამიანს დაანახოს განმეორებადი კავშირი და დაეხმაროს უკეთესი კითხვების დასმაში. მაგრამ სწორედ გაერთიანება ზრდის რისკსაც: მონაცემთა ერთი ელემენტი ხშირად უვნებელია, მათი კომბინაცია კი ჯანმრთელობის, ემოციური მდგომარეობის, სამუშაო ჩვევებისა და ადგილმდებარეობის დეტალურ პროფილს ქმნის.
საქართველოში მოთხოვნის საფუძველი უკვე არსებობს. საქსტატის 2025 წლის ICT კვლევის მიხედვით, ინტერნეტის მომხმარებლების 52.1% ჯანმრთელობის შესახებ ინფორმაციას ონლაინ ეძებდა. ეს არ ნიშნავს, რომ იგივე ადამიანები AI ჩატბოტებს პირად ბიომეტრიულ მონაცემებს უზიარებენ. თუმცა მაჩვენებელი ადასტურებს, რომ ციფრული არხი ჯანმრთელობის საკითხებზე პასუხის მოძიების ჩვეულებრივ ადგილად იქცა. გენერაციული AI ამ ჩვევას ახალ საფეხურზე გადაიყვანს: ძიების შედეგების ნაცვლად მომხმარებელი მიიღებს დიალოგს, რომელიც მისივე მონაცემებითაა პერსონალიზებული.
სამი განსხვავებული პროდუქტი, რომელსაც მომხმარებელი ხშირად ერთნაირად აღიქვამს
პირველი ტიპია კეთილდღეობის ასისტენტი: ის აჯამებს ვარჯიშს, ძილსა და კვებას და ადამიანს რუტინის მართვაში ეხმარება. მეორეა გადაწყვეტილების მხარდამჭერი ინსტრუმენტი, რომელიც სიმპტომებსა და გაზომვებს აერთიანებს და ექიმთან საუბრისთვის კითხვებს ამზადებს. მესამე კი სამედიცინო პროდუქტის ფუნქციას უახლოვდება – აფასებს რისკს, სთავაზობს მკურნალობის მსგავს მოქმედებას ან გავლენას ახდენს დიაგნოსტიკურ გადაწყვეტილებაზე.
ამ სამ კატეგორიას შორის საზღვარი მომხმარებლის ეკრანზე ხშირად არ ჩანს. მეგობრული ტონი, დეტალური პასუხი და პერსონალური მონაცემის მოხსენიება ქმნის ავტორიტეტის განცდას. მაგრამ პასუხის სიზუსტე შეიძლება დამოკიდებული იყოს მონაცემის ხარისხზე, მოდელის შეზღუდვებზე და იმაზე, იცის თუ არა სისტემამ მომხმარებლის სრული სამედიცინო ისტორია. საათის სენსორი, თვითშეფასება და ლაბორატორიული შედეგი ერთნაირი მტკიცებულება არ არის.
საქართველოში ეს განსხვავება კიდევ უფრო მნიშვნელოვანია, რადგან ონლაინ ინფორმაციის ძიება შეიძლება ნაწილობრივ ანაცვლებდეს სპეციალისტთან კონსულტაციას. რეგიონში მცხოვრები ან დროისა და ფასის შეზღუდვის მქონე ადამიანი AI პასუხს არა დამატებით ინსტრუმენტად, არამედ ხელმისაწვდომ ალტერნატივად აღიქვამს. WHO-ს 2025 წლის მიმოხილვა საქართველოს ტელემედიცინის განვითარებას სწორედ ხელმისაწვდომობის გაუმჯობესებას უკავშირებს და ხაზს უსვამს, რომ ციფრული მომსახურება საჭიროებს სამართლებრივ ჩარჩოს, კლინიკურ სახელმძღვანელოებს, დაფინანსებასა და მონიტორინგს. მომხმარებლის მიერ დამოუკიდებლად აწყობილი ჩატბოტი ამ სისტემური დაცვის გარეთ შეიძლება დარჩეს.
თანხმობა მხოლოდ ღილაკზე დაჭერა არ არის
საქართველოს პერსონალურ მონაცემთა დაცვის კანონი ჯანმრთელობის, ბიომეტრიულ და გენეტიკურ მონაცემებს განსაკუთრებული კატეგორიის მონაცემებად განიხილავს. კანონი ვრცელდება ავტომატურ დამუშავებაზეც და მოითხოვს მიზნის, საფუძვლისა და უსაფრთხოების შესაბამისობას. პრაქტიკული სირთულე ისაა, რომ მომხმარებელი მონაცემს ხშირად თავად აკოპირებს საერთაშორისო პლატფორმაში და თანხმობას იძლევა გრძელი, ზოგადი პირობებით.
ფორმალური თანხმობა ვერ პასუხობს ყველა არსებით კითხვას. ინახება თუ არა დიალოგი? გამოიყენება თუ არა ის მომსახურების გასაუმჯობესებლად ან მოდელის სწავლებისთვის? შეუძლია თუ არა მესამე მხარეს წვდომა? რა მოხდება ანგარიშის წაშლისას? სად მდებარეობს მონაცემი? შეიძლება თუ არა ჯანმრთელობის ჩანაწერის დაკავშირება სხვა პროფილთან? მომხმარებლისთვის ყველაზე მნიშვნელოვანი არჩევანი ხშირად არა „ვეთანხმები/არ ვეთანხმები“, არამედ „რომელი მონაცემი არის ამ კონკრეტული მიზნისთვის აუცილებელი“ უნდა იყოს.
მონაცემთა მინიმიზაცია პერსონალიზაციის უარყოფას არ ნიშნავს. მაგალითად, ძილის გრაფიკის გასაანალიზებლად შესაძლოა საჭირო იყოს ძილის დრო და დატვირთვა, მაგრამ არა სრული სამუშაო მიმოწერა, ზუსტი მდებარეობის ისტორია ან ოჯახის წევრების ინფორმაცია. რაც მეტი წყარო ერთიანდება, მით უკეთესი შეიძლება გახდეს კონტექსტი, თუმცა მით უფრო მძიმეა შესაძლო გაჟონვის, არასწორი ინტერპრეტაციისა და მეორადი გამოყენების შედეგი.
საილუსტრაციო მაგალითი – სასარგებლო კავშირი და სახიფათო დასკვნა
წარმოვიდგინოთ თბილისში დასაქმებული ადამიანი, რომელიც საათიდან იღებს ძილისა და გულისცემის მონაცემებს, კალენდრიდან – შეხვედრების განრიგს, ხოლო ჩატბოტი ყოველდღიურად აღწერს მის განწყობას. სისტემა ამჩნევს, რომ შეხვედრებით გადატვირთულ დღეებს ცუდი ძილი მოსდევს და ურჩევს საღამოს ვარჯიშის შემცირებას. ეს შეიძლება სასარგებლო ჰიპოთეზა იყოს.
მაგრამ თუ იგივე სისტემა რამდენიმე გაზომვის საფუძველზე აცხადებს, რომ ადამიანს კონკრეტული დაავადების მაღალი რისკი აქვს, სიტუაცია იცვლება. სენსორის შეცდომა, კოფეინი, ინფექცია, მედიკამენტი ან უბრალოდ არასრული ისტორია შეიძლება გამოტოვებული იყოს. პირველი პასუხი ქცევის ექსპერიმენტია; მეორე – სამედიცინო მნიშვნელობის დასკვნა. მომხმარებელმა უნდა იცოდეს, სად გადის ეს ზღვარი და როდის არის საჭირო პროფესიული შეფასება.
ბიზნესისთვისაც განსხვავება არსებითია. კეთილდღეობის აპმა შეიძლება გაზარდოს ჩართულობა, მაგრამ თუ იგი დამსაქმებელს თანამშრომლის სტრესის ან ჯანმრთელობის პროფილს გადასცემს, ნებაყოფლობითობა ეჭვქვეშ დგება. სამუშაო გარემოში თანხმობა განსაკუთრებით ფრთხილად უნდა შეფასდეს, რადგან თანამშრომელს შეიძლება უარის თქმის რეალური თავისუფლება არ ჰქონდეს. პროდუქტიულობის ინსტრუმენტი ადვილად შეიძლება გადაიქცეს ზედამხედველობის სისტემად.
როგორ იქმნება ნდობა
სანდო AI ჯანმრთელობის ასისტენტი პირველ რიგში საკუთარ როლს ზუსტად უნდა ასახელებდეს. მომხმარებელს უნდა ესმოდეს, აკეთებს სისტემა მონაცემთა შეჯამებას, ქმნის ზოგად საგანმანათლებლო პასუხს თუ იყენებს კლინიკურად შემოწმებულ მოდელს. მეორე პირობაა მონაცემის წარმოშობის ჩვენება: რომელი დასკვნა მოდის საათიდან, რომელი – მომხმარებლის აღწერიდან და რომელი – ზოგადი ცოდნიდან. მესამეა გაურკვევლობის გამჟღავნება, განსაკუთრებით მაშინ, როდესაც მონაცემი არასრული ან წინააღმდეგობრივია.
მეოთხე პირობაა კონტროლი. ადამიანს უნდა შეეძლოს ცალკეული წყაროს გამორთვა, ისტორიის წაშლა და მონაცემის ექსპორტი. მეხუთეა ესკალაცია: მაღალი რისკის სიმპტომის ან არასაიმედო მონაცემის შემთხვევაში სისტემა არ უნდა თამაშობდეს ექიმის როლს. იგი მომხმარებელს უნდა ეხმარებოდეს პროფესიონალთან გადასაცემი ინფორმაციის დალაგებაში.
ეს პრინციპები მხოლოდ ტექნიკური შესაბამისობა არ არის. ისინი ბიზნესმოდელის საკითხია. პლატფორმა, რომელიც მეტ მონაცემს აგროვებს, შეიძლება მოკლევადიანად უკეთეს პერსონალიზაციას აჩვენებდეს, მაგრამ ნდობის დაკარგვისას მომხმარებლის დატოვება უფრო სწრაფი იქნება. ჯანმრთელობის მონაცემებში ერთჯერადი შეცდომის ფასი ჩვეულებრივი რეკომენდაციის შეცდომაზე მაღალია.
რატომ არ არის ყველა პერსონალიზაცია ერთნაირად ღირებული
პერსონალიზაციის ხარისხი შეგროვებული ველების რაოდენობით არ იზომება. ზოგჯერ უფრო მცირე, მაგრამ ზუსტად შერჩეული მონაცემი უკეთეს გადაწყვეტილებას ქმნის, ვიდრე დიდი და ხმაურიანი პროფილი. თუ მომხმარებელი ყოველდღიურად ავსებს განწყობას, მაგრამ სხვადასხვა დღეს ერთსა და იმავე სიტყვას განსხვავებული მნიშვნელობით იყენებს, მოდელი შესაძლოა ცრუ ტენდენციას ხედავდეს. თუ საათი ხშირად იხსნება ან მოწყობილობა შეიცვალა, დროითი შედარებაც ირღვევა. მონაცემის რაოდენობა მის თანმიმდევრულობას ვერ ანაცვლებს.
საქართველოს ბაზარზე ამას პრაქტიკული შედეგი აქვს. ქართულენოვანი მომხმარებელი შეიძლება სიმპტომს ან ემოციურ მდგომარეობას ადგილობრივი გამოთქმით აღწერდეს, რომელსაც საერთაშორისო მოდელი ზუსტად ვერ განმარტავს. წამლის სავაჭრო სახელიც შეიძლება განსხვავდებოდეს მოდელის ძირითად სასწავლო გარემოში გავრცელებული სახელისგან. ამიტომ ენობრივი გამართულობა მხოლოდ კომფორტი არ არის: ჯანმრთელობის კონტექსტში იგი უსაფრთხოების ნაწილია. სისტემამ ბუნდოვანი ტერმინი უნდა დააზუსტოს და არა თავდაჯერებული დასკვნა გამოიტანოს.
მნიშვნელოვანია მონაცემის გადატანადობაც. თუ მომხმარებელმა რამდენიმე წლის ჯანმრთელობის ისტორია ერთ აპში დააგროვა, მაგრამ მისი გასაგებ ფორმატში გატანა ვერ შეძლო, პერსონალიზაცია დამოკიდებულებად იქცევა. კონკურენტულ ბაზარს სჭირდება შესაძლებლობა, რომ ადამიანმა საკუთარი ჩანაწერი სხვა სერვისში ან ექიმთან გადაიტანოს. მონაცემი მომხმარებლის ჯანმრთელობის ისტორიაა და არა მხოლოდ პლატფორმის პროდუქტის საწვავი.
დაბოლოს, პასუხისმგებლობა არ უნდა დაიკარგოს მონაწილეებს შორის. მოწყობილობის მწარმოებელი შეიძლება სენსორის სიზუსტეზე პასუხობდეს, აპი – გამოთვლაზე, AI პლატფორმა – ტექსტურ ინტერპრეტაციაზე, ხოლო მომხმარებელი – შეყვანილ ინფორმაციაზე. შეცდომისას ეს ჯაჭვი ბუნდოვანი ხდება. სანდო პროდუქტი წინასწარ აჩვენებს, რომელი რგოლი რას აკეთებს და სად მთავრდება მისი პასუხისმგებლობა.
ამავე მიზეზით, ჯანმრთელობის AI-ის შედეგის შეფასება მხოლოდ ჩართულობის ხანგრძლივობით არ შეიძლება. ხშირი გამოყენება შეიძლება ნიშნავდეს სარგებელს, მაგრამ ასევე შფოთვით განმეორებით შემოწმებას. უფრო მნიშვნელოვანი მაჩვენებლებია: მიიღო თუ არა მომხმარებელმა გასაგები ინფორმაცია, შემცირდა თუ არა გაურკვევლობა, შეძლო თუ არა მონაცემის კონტროლი და საჭიროებისას გადავიდა თუ არა კვალიფიციურ დახმარებაზე.
BTU-ს მკვლევრების შეფასება
BTU-ს მკვლევრების შეფასებით, ჯანმრთელობის AI ასისტენტების მთავარი კონკურენტული უპირატესობა პასუხების სიმრავლე კი არა, მონაცემისა და რჩევის საზღვრების მართვა იქნება. ყველაზე სანდო სისტემა არ არის ის, რომელიც ყველაფერს „იცნობს“ მომხმარებელზე; ისაა, რომელიც თითოეული მონაცემის საჭიროებას ხსნის, გაურკვევლობას აჩვენებს და მკაფიოდ ასხვავებს კეთილდღეობის რჩევას სამედიცინო გადაწყვეტილებისგან.
საქართველოსთვის მთავარი შესაძლებლობა ციფრული ჯანმრთელობის მიმართ უკვე არსებული ინტერესის უსაფრთხო გამოყენებაა. მაგრამ თუ პერსონალიზაცია მონაცემთა მაქსიმალურ შეგროვებას გაუტოლდება, მომხმარებელი მიიღებს კომფორტულ პასუხს კონტროლის დაკარგვის ფასად. ღირებულება იქმნება მაშინ, როდესაც AI ადამიანს უკეთეს კითხვას, უკეთ ორგანიზებულ ჩანაწერს და დროულ პროფესიულ მიმართვას აძლევს – და არა მაშინ, როდესაც იგი არასრული მონაცემით ექიმის ავტორიტეტს იმეორებს.
ძირითადი მიგნებები
- 2025 წელს საქართველოს ინტერნეტის მომხმარებელთა 52.1% ჯანმრთელობასთან დაკავშირებულ ინფორმაციას ონლაინ ეძებდა, რაც AI-ზე დაფუძნებული პერსონალიზაციისთვის მზა მოთხოვნის გარემოს აჩვენებს.
- ჯანმრთელობის სხვადასხვა მონაცემის გაერთიანება სასარგებლო კავშირებს ავლენს, მაგრამ ერთდროულად ქმნის ბევრად უფრო მგრძნობიარე პროფილს.
- კეთილდღეობის ასისტენტი, გადაწყვეტილების მხარდამჭერი ინსტრუმენტი და სამედიცინო პროდუქტი სხვადასხვა პასუხისმგებლობას მოითხოვს, მიუხედავად იმისა, რომ მომხმარებლისთვის ერთნაირად შეიძლება გამოიყურებოდეს.
- საქართველოს კანონში ჯანმრთელობის, ბიომეტრიული და გენეტიკური მონაცემები განსაკუთრებული კატეგორიისაა; მათი გაზიარება ჩვეულებრივი აპის მონაცემის მიწოდებას არ უნდა გაუტოლდეს.
- მონაცემთა მინიმიზაცია პერსონალიზაციას არ გამორიცხავს – იგი ამოწმებს, ნამდვილად საჭიროა თუ არა თითოეული წყარო დასახელებული მიზნისთვის.
- სამუშაო გარემოში ჯანმრთელობისა და სტრესის მონაცემების გამოყენება ზრდის ზედამხედველობისა და არათავისუფალი თანხმობის რისკს.
- გრძელვადიან ნდობას ქმნის როლის მკაფიო აღწერა, მონაცემის წარმოშობა, გაურკვევლობის ჩვენება, მომხმარებლის კონტროლი და პროფესიონალთან დროული ესკალაცია.
რატომ არის ეს მნიშვნელოვანი საქართველოსთვის
ციფრული ჯანმრთელობა საქართველოში ხელმისაწვდომობის პრობლემის ნაწილის შემსუბუქებას შეძლებს, განსაკუთრებით რეგიონებში. თუმცა პერსონალური ჩატბოტი და რეგულირებულად ორგანიზებული ტელემედიცინა ერთი და იგივე რამ არ არის. თუ მომხმარებელი ამ განსხვავებას ვერ ხედავს, ტექნოლოგიური ხელმისაწვდომობა შეიძლება გადაიქცეს დიაგნოზის დაგვიანებად, ზედმეტ შფოთვად ან მგრძნობიარე მონაცემის უკონტროლო გავრცელებად. საქართველოსთვის საჭიროა არა ნაკლები ციფრული ინოვაცია, არამედ ისეთი ბაზარი, სადაც მომხმარებელი ხედავს პროდუქტის რეალურ ფუნქციას და ინარჩუნებს არჩევანს საკუთარ მონაცემზე.
დასკვნა
AI-ს შეუძლია დაშლილი ჯანმრთელობის მონაცემები ადამიანისთვის გასაგებ ისტორიად აქციოს. ეს რეალური ღირებულებაა. მაგრამ პერსონალიზებული ენა მტკიცებულების ხარისხს არ ზრდის და მეგობრული ჩატბოტი ავტომატურად სამედიცინო ინსტრუმენტი არ ხდება.
ინერციული გზით მომხმარებლები სულ უფრო მეტ მონაცემს გააერთიანებენ ისე, რომ ვერ გაარკვევენ მის მომავალ გამოყენებასა და პასუხის კლინიკურ საზღვრებს. უფრო ძლიერი არჩევანია მიზნობრივი გაზიარება: იმდენი მონაცემი, რამდენიც კონკრეტულ ამოცანას სჭირდება; მკაფიო განსხვავება რჩევასა და დიაგნოზს შორის; და ადამიანის ხელში დარჩენილი კონტროლი. AI-ის წარმატება საბოლოოდ შეფასდება არა მხოლოდ იმაზე დაყრდნობით, თუ რამდენად ხშირად გასცემს სწორ პასუხს, არამედ რამდენად ზუსტად იცის, როდის არ უნდა უპასუხოს როგორც ექიმმა.
მონაცემები და ძირითადი წყაროები
- The Wall Street Journal, “The Datamaxxers Feeding Their Every Health Move to AI”, 12 August 2026, მომხმარებლის მიერ მოწოდებული ბეჭდური გამოცემა.
- საქსტატი, ICT-ის გამოყენება შინამეურნეობებში, 2025: https://www.geostat.ge/media/72941/Indicators-of-Using-Information-and-Communication-Technologies-%28ICT%29-in-Households.pdf
- საქართველოს კანონი პერსონალურ მონაცემთა დაცვის შესახებ: https://www.matsne.gov.ge/en/document/view/5827307?publication=1
- WHO, Turning telemedicine into a core health-care service in Georgia, 1 October 2025: https://www.who.int/georgia/news/item/01-10-2025-turning-telemedicine-into-a-core-health-care-service-in-georgia
მასალა არის ანალიტიკური და საგანმანათლებლო ხასიათის. ის არ წარმოადგენს სამედიცინო რეკომენდაციას, დიაგნოზს ან მკურნალობის ინსტრუქციას. კონკრეტული პრობლემის შემთხვევაში საჭიროა შესაბამის სპეციალისტთან კონსულტაცია.
მომზადებულია BTU-ის აკადემიური გუნდისა და BTUAI მკვლევართა გუნდის მიერ, თბილისი, საქართველო.